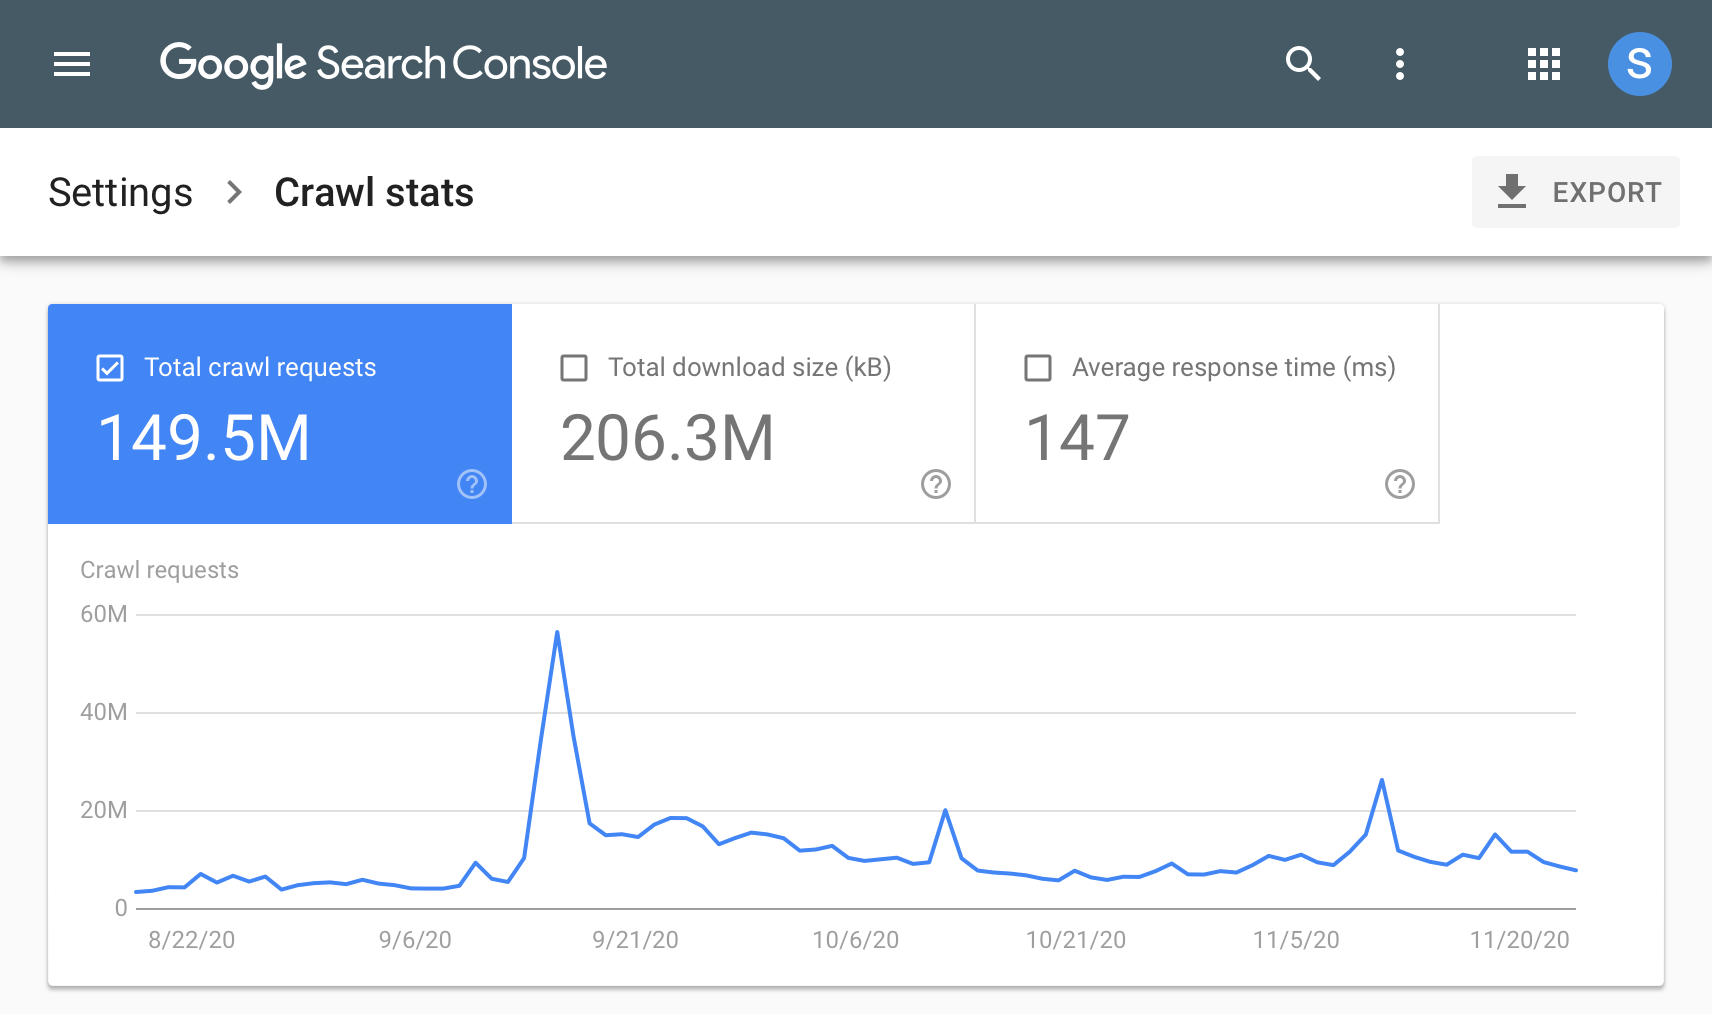
Onglet Performances, courbe des clics : la majorité des utilisateurs de Google Search Console ferment l’outil sans creuser plus loin. L’interface cache pourtant beaucoup plus que cette courbe. Sur ce site, la requête « faire un diagnostic seo » se positionne en 10,4 quand « faire un rapport seo » stagne en position 48. Même famille de sujet, destin opposé. La seule façon de comprendre l’écart tient dans le croisement des rapports entre eux, jamais dans leur lecture isolée. Cinq de ces croisements sont gratuits et aucun guide français ne les détaille de cette façon : la cannibalisation démasquée en trois clics, l’effet des réponses génératives repéré par un filtre CTR, le canonical réellement retenu par Google, les pages fantômes du rapport de couverture, et l’export qui fait sauter la limite des mille lignes.
EN BREF
Cinq croisements gratuits changent la lecture de Google Search Console : le croisement requête et page pour démasquer la cannibalisation, le filtre CTR et position pour repérer l’effet des réponses génératives, l’inspection d’URL pour lire le canonical réellement choisi par Google, le rapport de couverture pour retrouver les pages jamais explorées, et l’API pour dépasser la limite des mille lignes. Aucun de ces cinq leviers ne coûte un centime.
Pourquoi la plupart des utilisateurs de Google Search Console passent-ils à côté de l’essentiel ?
Google Search Console n’est pas un tableau de bord à consulter une fois par mois. C’est un terrain d’enquête. Trois habitudes limitent structurellement ce que vous en tirez : la vue par défaut, la limite de lignes et le mauvais type de propriété.
Que manque-t-on en restant sur la vue Performances par défaut ?
La vue par défaut du rapport Performances affiche les clics et les impressions des trois derniers mois, tous mots-clés confondus. C’est une photo d’ensemble, pas un diagnostic. Le travail commence quand vous cliquez sur une requête précise pour ouvrir l’onglet Pages, ou sur une page pour ouvrir l’onglet Requêtes. Chaque clic de ce type change le sens des données affichées.
Quand je mène un audit, je pars systématiquement de ces croisements plutôt que des totaux affichés en haut de l’écran. Pour qui veut apprendre à réaliser un audit SEO soi-même, c’est le premier réflexe à prendre : ne jamais lire un chiffre agrégé sans se demander ce qu’il cache. Un site peut afficher un taux de clic moyen honorable et dissimuler, sous cette moyenne, une moitié de pages qui ne reçoivent aucun clic.
La mesure de la performance SEO ne se limite pas à surveiller une courbe qui monte. Les KPI SEO réellement décisifs ne sont jamais les totaux du graphique, mais les écarts obtenus en isolant une requête, une page ou un pays.
Pourquoi la limite de mille lignes fausse-t-elle vos analyses ?
Chaque rapport exporté depuis l’interface est tronqué à mille lignes, quel que soit le nombre réel de requêtes ou de pages derrière ce total. Google le précise dans son centre d’aide : les données téléchargées correspondent à un échantillon représentatif, pas à l’intégralité du jeu de données. Pour un petit site, mille lignes couvrent souvent la totalité du trafic. Pour un site de taille moyenne ou grande, elles n’en couvrent qu’une fraction, et cette fraction favorise mécaniquement les requêtes déjà fortes.
Le problème reste invisible tant que vous ne cherchez rien de précis. Il devient réel dès que vous voulez auditer la longue traîne ou repérer une cannibalisation entre deux pages secondaires. Les lignes qui manquent sont précisément celles qui portent l’information la plus actionnable.
La solution existe et elle est gratuite : l’API Search Console. Elle relève le plafond à cinquante mille lignes par jour, par propriété et par type de recherche. Cela suppose un minimum de manipulation technique, ou un connecteur comme Looker Studio, mais aucun abonnement à payer.
LE CALCUL
Export standard depuis l’interface : 1 000 lignes maximum. Export via l’API Search Console : jusqu’à 50 000 lignes par jour, par propriété et par type de recherche. Cela représente cinquante fois plus de données accessibles, sans dépenser un centime de plus que ce que l’interface propose déjà gratuitement.
Propriété de domaine ou préfixe d’URL, qu’est-ce que cela change ?
Au moment de créer une propriété, Google propose deux formats. La propriété de domaine regroupe automatiquement tous les sous-domaines et tous les protocoles : http, https, www et non-www. La propriété avec préfixe d’URL se limite à l’adresse exacte que vous avez déclarée, rien de plus.
La conséquence pratique est directe. Un site qui a migré du http vers le https, ou qui reçoit du trafic sur une variante www et une variante sans www, verra ses données réparties entre plusieurs propriétés distinctes s’il reste en préfixe d’URL. Chaque propriété affiche alors une image partielle. C’est la somme qui manque.
Je recommande la propriété de domaine dès que la validation par DNS est possible. Elle demande un accès à la zone DNS de l’hébergeur, ce qui bloque parfois les équipes pressées, mais elle évite ensuite de recoller des fragments de données à la main pendant des années.
Comment détecter la cannibalisation avec le croisement requête par page ?
La cannibalisation de mots-clés est l’angle mort numéro un des sites qui publient depuis longtemps. Deux pages, une seule requête visée, et Google qui hésite entre les deux. Search Console la révèle en trois clics, sans outil tiers.
DÉFINITION
La cannibalisation de mots-clés désigne la situation où plusieurs pages d’un même site ciblent la même requête. Google doit arbitrer laquelle afficher, ce qui dilue l’autorité de chacune et empêche souvent les deux de bien se positionner.
Comment filtrer sur une requête pour voir toutes les pages concernées ?
Ouvrez le rapport Performances, filtrez sur une requête précise, puis basculez sur l’onglet Pages plutôt que de rester sur Requêtes. Cette bascule affiche toutes les URL de votre site qui ont reçu des impressions ou des clics pour cette requête exacte, sur la période choisie.
Si une seule page apparaît, il n’y a rien à corriger. Si deux ou plusieurs pages apparaissent avec des volumes comparables, vous tenez une cannibalisation active. C’est précisément ce que la plupart des guides omettent : décrire l’onglet Pages et l’onglet Requêtes séparément, jamais le passage filtré de l’un à l’autre.
Une architecture bien pensée limite ce risque en amont. Construire un cocon sémantique organise les pages autour d’intentions de recherche distinctes, avec une hiérarchie claire entre page pilier et pages de soutien. Sans cette structure, chaque nouvel article publié augmente mécaniquement le risque de chevauchement avec un contenu existant.
À partir de combien d’URL concurrentes faut-il agir ?
Deux pages qui apparaissent pour la même requête ne signifient pas automatiquement un problème. Le signal à surveiller est la répartition des clics. Si une page capte l’écrasante majorité du volume et l’autre ne reçoit que des miettes, il s’agit probablement d’un chevauchement naturel et sans conséquence.
Le vrai signal d’alerte apparaît quand les deux pages se partagent le volume de façon proche, ou quand leurs positions respectives oscillent d’une semaine à l’autre sans qu’aucune ne se stabilise. Cette instabilité trahit l’hésitation de l’algorithme, pas une fluctuation normale.
Prioriser les actions d’un audit SEO commence exactement ici : classer les cas de cannibalisation par volume d’impressions concerné, puis traiter en premier les paires de pages qui portent le plus de trafic potentiel. Un chevauchement sur une requête à cinquante impressions par mois attendra. Un chevauchement sur une requête à cinq mille impressions ne devrait pas.
Comment identifier la page que Google préfère réellement ?
Dans l’onglet Pages du croisement filtré par requête, triez par clics ou par impressions. L’URL en tête du classement est celle que Google favorise actuellement dans ses résultats, indépendamment de celle que vous auriez souhaité voir ressortir.
Cette information oriente directement la correction. Si la page que Google préfère correspond à votre intention éditoriale, renforcez-la et redirigez ou fusionnez l’autre. Si Google préfère une page secondaire, mal optimisée ou plus ancienne, c’est le signal que vos liens internes envoient un message contraire à votre intention.
Croiser ce classement avec l’outil d’inspection d’URL confirme le diagnostic : il affiche le canonical que Google a retenu, qui recoupe presque toujours la page en tête du classement des clics. J’y reviens plus loin, car le même outil sert à bien d’autres diagnostics.
Quels croisements révèlent l’impact des réponses génératives ?
Les AI Overviews et les résumés générés par l’IA répondent parfois à la question avant que l’internaute ne clique. Search Console garde la trace de cet effet, à condition de savoir où regarder.
Comment isoler un CTR effondré à position stable ?
La signature est précise et facile à repérer une fois qu’on la connaît. Une requête conserve une position moyenne stable, parfois excellente, en première page. Dans le même temps, son taux de clic s’effondre par rapport à ce qu’une position équivalente génère habituellement. La page ne perd pas en visibilité, elle perd en clics, parce que la réponse apparaît directement dans les résultats avant que l’internaute n’ait besoin de cliquer.
Pour repérer ce phénomène, filtrez le rapport Performances par requête, affichez la position moyenne et le CTR sur la même période, et cherchez les courbes qui divergent : position plate, CTR en pente descendante. Diagnostiquer une baisse de trafic SEO commence par cette dissociation entre les deux métriques. Un CTR qui chute alors que la position tient bon n’a pas la même cause, ni le même remède, qu’une perte de position classique.
Les requêtes informationnelles courtes, celles qui appellent une réponse en une phrase, sont les plus exposées à ce phénomène. Les requêtes qui demandent une comparaison, un avis ou une démonstration résistent nettement mieux.
Comment comparer deux périodes sur une requête unique ?
Le rapport Performances propose un filtre de comparaison entre deux plages de dates. Appliqué sur l’ensemble du site, il donne une vision globale. Appliqué sur une seule requête, filtrée au préalable, il isole l’effet propre à cette requête et l’écarte du bruit du reste du site.
Cette distinction change l’interprétation. Si le CTR chute uniquement sur des requêtes informationnelles précises pendant qu’il reste stable sur vos requêtes commerciales ou de marque, l’explication la plus probable est un changement d’affichage dans les résultats de recherche, comme un résumé généré par l’IA. Si la chute touche l’ensemble de vos requêtes sans distinction, la cause est plus probablement une mise à jour d’algorithme ou un problème technique du site.
Cette comparaison requête par requête prend cinq minutes une fois la méthode connue. Elle évite de tirer des conclusions générales à partir d’un symptôme qui, en réalité, ne concerne qu’une poignée de pages.
Comment exploiter l’inspection d’URL et les rapports d’indexation ?
L’outil d’inspection d’URL et le rapport de couverture sont souvent réduits à un contrôle de conformité avant publication. Utilisés en continu, ils deviennent un outil de diagnostic à part entière.
Que révèle le canonical choisi par Google quand il diffère du vôtre ?
L’outil d’inspection d’URL affiche deux informations distinctes pour chaque page : le canonical que vous avez déclaré dans votre code, et le canonical que Google a effectivement retenu pour l’indexation. Ces deux valeurs correspondent la plupart du temps. Quand elles divergent, Google vous informe qu’il n’indexe pas la page que vous souhaitiez voir ressortir, mais une autre.
Les causes les plus fréquentes tiennent à la structure du site : des liens internes qui pointent majoritairement vers une variante différente de celle déclarée en canonical, un contenu jugé trop proche d’une autre page, ou un sitemap qui ne reflète plus l’architecture réelle. Structurer l’arborescence de votre site limite ce risque, parce qu’une hiérarchie claire entre les pages envoie des signaux cohérents à Google plutôt que des signaux contradictoires.
Corriger ce type de divergence demande rarement une intervention lourde : renforcer le maillage interne vers la bonne URL, vérifier que le sitemap ne liste que les pages canoniques, puis retester la page dans l’outil d’inspection.
Comment repérer les pages jamais explorées malgré le sitemap ?
Un sitemap soumis n’est pas une garantie de crawl, encore moins d’indexation. Le rapport de couverture classe chaque URL par statut : indexée, explorée mais non indexée, ou découverte mais jamais explorée.
Ce dernier statut mérite une attention particulière. Une page découverte par Google, généralement parce qu’elle figure dans le sitemap ou dans un lien interne, mais jamais explorée, signale un problème de priorité de crawl. Google a repéré son existence et a choisi de ne pas dépenser de budget de crawl pour aller la lire.
Sur un site de taille modeste, ce statut reste rare. Sur un site plus large, il grandit avec le nombre de pages à faible valeur perçue : archives, pages de filtre, contenus dupliqués. La correction ne consiste pas à insister auprès de Google, mais à renforcer les signaux internes qui pointent vers ces pages, ou à accepter qu’elles ne méritent pas d’être indexées et à les retirer du sitemap.
Quelles pages en redirection polluent encore votre sitemap ?
Un sitemap ne devrait contenir que des URL qui répondent avec un code 200 et qui correspondent à la version canonique de chaque page. Dans les faits, après une refonte ou une migration, il n’est pas rare d’y retrouver des adresses redirigées depuis longtemps.
Le rapport de couverture identifie ces cas sous un statut de type page avec redirection. Chaque URL redirigée listée dans le sitemap consomme du budget de crawl pour rien : Google la visite, suit la redirection, et n’apprend rien de nouveau qu’il ne savait déjà.
Nettoyer un sitemap prend peu de temps une fois la liste des URL en redirection identifiée. C’est un chantier technique mineur, mais il fait partie des corrections qui, cumulées, libèrent du budget de crawl pour les pages qui en ont réellement besoin.
À RETENIR
Trois vérifications suffisent pour transformer l’inspection d’URL et le rapport de couverture en outil de diagnostic : comparer le canonical déclaré et le canonical retenu par Google, repérer les pages découvertes mais jamais explorées, et retirer du sitemap les URL redirigées. Aucune de ces trois actions ne nécessite d’outil payant.
Comment automatiser l’export sans devenir développeur ?
L’interface de Search Console suffit pour un diagnostic ponctuel. Elle ne suffit plus pour un suivi dans la durée, à cause de la limite de lignes et de la purge des données anciennes.
Quelles solutions existent pour dépasser l’interface ?
L’API Search Console reste la base : gratuite, elle relève le plafond de lignes exportables et permet d’automatiser une extraction régulière. Elle demande un minimum de configuration technique, généralement prise en charge en une seule fois par un développeur ou un profil technique.
Pour qui préfère éviter le code, Looker Studio se connecte directement à Search Console et affiche les données au-delà de la limite de mille lignes de l’interface classique, avec des tableaux personnalisables et un export possible vers Sheets ou Excel. Des modules complémentaires pour tableurs offrent une alternative légère pour des besoins ponctuels.
Aucune de ces solutions ne remplace la lecture humaine des résultats. Elles retirent simplement le plafond technique qui empêche de voir l’ensemble du terrain plutôt qu’un échantillon tronqué.
Comment archiver ses données avant la purge des seize mois ?
Search Console conserve les données de performance sur une fenêtre glissante de seize mois. Passé ce délai, les données disparaissent de l’interface sans possibilité de récupération, quelle que soit la taille du site.
Pour un usage ponctuel, un export mensuel manuel en CSV suffit à constituer un historique de secours. Pour un suivi structuré dans la durée, Google propose l’export en masse vers BigQuery, une fonctionnalité qui programme un envoi quotidien de la totalité des données de performance, sans être limitée par le plafond de mille lignes. La configuration demande un projet Google Cloud et quelques droits d’accès, mais aucun développement sur mesure.
Archiver ses données n’a rien d’un réflexe d’expert. C’est une hygiène de base, au même titre qu’une sauvegarde de site, et elle évite de perdre l’historique nécessaire pour mesurer une trajectoire sur plusieurs années plutôt que sur seize mois glissants.
L’outil que vous avez déjà vaut mieux que celui que vous n’achetez pas
Les cinq croisements décrits dans cet article ne demandent ni budget ni outil tiers. Ils demandent de sortir de la vue par défaut et d’aller chercher l’information là où elle se trouve réellement : dans le passage d’un onglet à l’autre, dans la comparaison de deux périodes, dans le détail d’une inspection d’URL.
La tentation est grande d’acheter un outil payant avant d’avoir épuisé ce que l’outil gratuit propose déjà. Je préfère l’ordre inverse. Search Console mal exploité donne une fausse impression de maîtrise. Search Console croisé dans tous les sens donne une vision fidèle de ce qui se passe réellement sur votre site.
Si cette lecture croisée vous semble chronophage à mettre en place seul, je peux faire lire vos données par un consultant qui les manipule chaque semaine.
Sources et références
Cet article s’appuie notamment sur la documentation officielle de Google concernant l’export des rapports de performance, qui précise la limite de mille lignes appliquée à chaque téléchargement depuis l’interface, ainsi que sur son guide de configuration des propriétés de site, qui détaille la différence entre propriété de domaine et propriété avec préfixe d’URL. L’annonce officielle de la fonctionnalité d’export en masse vers BigQuery, publiée sur le blog Search Central de Google, éclaire les limites du plafond quotidien de lignes et les solutions pour les dépasser. La documentation technique de Google sur la résolution des problèmes de canonicalisation précise les causes les plus courantes d’un canonical retenu par Google différent de celui déclaré par le site. Enfin, le guide des rapports clés de Search Console rédigé par le consultant Josselin Leydier détaille la fenêtre de conservation des données sur seize mois glissants et les options d’archivage disponibles.
FAQ - Ce que l’interface ne précise jamais d’elle-même
Les données de Search Console sont-elles échantillonnées ?
Non, les données affichées ne sont pas échantillonnées au sens statistique. Elles sont en revanche filtrées et parfois agrégées différemment pour protéger la confidentialité des utilisateurs, ce qui explique pourquoi certains totaux ne correspondent pas exactement à la somme des lignes détaillées.
Pourquoi les chiffres diffèrent-ils de ceux de GA4 ?
Search Console mesure les impressions et les clics dans les résultats Google, avant même que l’internaute n’arrive sur le site. GA4 mesure les sessions une fois que le visiteur est arrivé, après le chargement de la page. L’écart entre les deux outils est donc normal et attendu.
Combien de temps Search Console conserve-t-il l’historique ?
Les données de performance sont conservées sur une fenêtre glissante de seize mois. Au-delà, elles disparaissent définitivement de l’interface, sauf si vous les avez exportées ou si vous avez configuré un export en masse au préalable.
Peut-on suivre plusieurs sites depuis un même compte ?
Oui, un compte Google peut gérer un nombre illimité de propriétés Search Console. Chaque propriété reste indépendante, avec ses propres accès et ses propres données, ce qui convient aussi bien à une entreprise multi-sites qu’à un consultant qui pilote plusieurs clients.
Que signifie exactement une position moyenne décimale ?
La position moyenne décimale reflète la moyenne des positions obtenues par une page ou une requête sur toutes les impressions de la période, tous appareils et toutes localisations confondus. Une position de 10,4 signifie que la page apparaît le plus souvent en bas de première page ou en haut de seconde page, selon les recherches.
L’outil de suppression d’URL a-t-il un effet durable ?
Non, l’outil de suppression d’URL masque temporairement une page des résultats Google, pendant environ six mois. Il ne remplace jamais une vraie solution technique comme une balise noindex ou une suppression définitive du contenu.
Comment donner un accès limité à un prestataire ?
La Search Console permet d’ajouter un utilisateur avec un rôle restreint, en lecture seule, sans lui donner les droits de propriétaire du compte. C’est le niveau d’accès à privilégier pour un prestataire ponctuel qui n’a pas besoin de modifier les paramètres du site.